

Teknik memakai X-Robots-Tag HTTP header sebenarnya sudah lama dan bagi beberapa kalangan ini old school atau lebih menganggap sudah gak jamannya lagi.
Sah-sah saja kamu lebih menyukai memakai robots teks file daripada x-robots-tag untuk seting semuanya tapi setelah membaca penjelasan di artikel ini nantinya saya yakin kamu akan berfikir ulang untuk mengabaikannya.
Cara tersebut sudah dipakai banyak webmaster sejak tahun 2008 silam, bagi beberapa orang fungsi x-robots-tag http header ini sekilas mirip file robots.txt.
Pada kenyataannya bahwa Robots.txt file adalah sinyal bagi bot mesin pencari mana yang boleh dirayapi (crawl) dan mana yang tidak, bukan mana yang boleh diindeks mana yang tidak.
Sinyal untuk indeks ini ada dua yaitu memakai meta tag noindex (dipasang dibagian header halaman html) dan x-robots-tag http header ini (pure untuk robot search engine).
Seberapa Penting File Robots text
Btw, Robot txt tetap penting tapi hanya sebatas yang umum saja tidak mendetail jadi saya pribadi lebih menyarankan memakai keduanya yaitu X-Robots-Tag HTTP header dan robots.txt.
Tapi disesuaikan kebutuhan terutama untuk robots teks sebisa mungkin simple saja atau bahkan hanya “Disallow: ” yang artinya boleh semua.
Jika tidak ada file robots.txt salah juga karena ini adalah sinyal bot mesin pencari mengetahui boleh tidaknya dirayapi website tersebut dan ini adalah TOS dari mesin pencari / search engine.
Sekilas file robots.txt seakan-akan sinyal untuk mana yang boleh diindeks dan tidak, padahal robot teks file ini hanya sebatas:
Mana yang boleh di rayapi / crawled oleh bot mesin pencari dan mana yang tidak
Meskipun memang pada kenyataannya file yang tidak boleh di crawl oleh bot ini kemungkinan besar tidak diindeks tapi bukan berarti sinyal tidak boleh diindeks (malah kebanyakan diindeks loh).
Gak percaya ?
Cek saja url atau folder yang kamu disallow di robots.txt. Untuk posisinya di root website seperti domainku/robots.txt.
Saya tidak bahas teknik cara agar boleh di crawl (dirayapi mesin pencari) atau tidaknya di file robots.txt (disallow, allow) bisa cari di google cara detailnya dan cukup mudah kok.
Kenapa Harus Menggunakan X-Robots-Tag HTTP Header Daripada Seeting di File robots.txt ?
Menyarankan disini bukan berarti tidak memakai file robots.txt sama sekali, tapi lebih ke elemen-elemen file / folder detail tidak perlu diset di file robots.txt.
Jadi apa yang ada di robots text tersebut yang bersifat general saja hanya beberapa sedikit “disallow” saja dan untuk”allow” tidak perlu di pasang juga kok.
Harus difahami dulu konteks crawl & index, crawl = proses, index = hasil.
Ketika dalam file robots.txt banyak yang di disallow, ini mengganggu proses perayapan termasuk mobile friendly signal.
Khususnya web penganut responsive aka tidak memiliki web khusus mobile seperti m.mywebsite.com atau mobile.mywebsite.com atau mywebsite.com/amp.
Ada sebagian yang bilang, oh bisa dipasang async kok, atau di defer !
Man, it’s about disallow robots.txt not pagespeed or compatible, mau dipasang async pun toh scriptnya ada dalam folder yang di disallow robots teks.
Jika kamu memakai robots teks jika tidak hati-hati maka justru efek buruk SEO web yang akan didapat, sebagai contoh file wp-content dalam web cms wordpress.
Disana terdapat folder yang bagus kalau di noindex in tapi juga ada folder yang tidak boleh di noindex.
Proses render dari bot terhambat, sementara banyak juga file yang ingin diindeks atau bahkan dioptimasi SEO nya biar pageone terdapat file di bagian header yang di seting disallow di robots.txt.
Ini bisa berefek proses indexing lambat dalam website tersebut
Maksudnya begini, Ada halaman /page atau post yang ingin diindeks atau bahkan dioptimasi dan malah maunya di pageone.
Dalam halaman tersebut terdapat file-file JS atau CSS dan lainnya atau bahkan terkoneksi dengan fungsi API yang di set disallow di robots.txt otomatis ini menghambat proses render crawl oleh bot search engine.
Itu baru satu, bayangkin kalo semua halaman web seperti itu?
Kenyataannya biasanya banyak website seperti itu terutama “ecommerce” yang terdapat banyak eksternal script dan css sementara kalo dibuat inline script atau css tentu terlalu banyak.
Robot mesin pencari bingung loh, halaman web ini maunya pengen di crawl tapi banyak elemen2 nya di block untuk doi alhasil proses crawling jadi buruk.
 Jika kamu seting dengan benar setiap folder di robots.txt file.
Tentu akan sangat banyak banget berjejer di path-path folder tersebut sementara robots.txt tersebut bersifat public atau bisa diakses orang-orang.
Nah ketahuan nama-nama path folder website kamu kan?
Bayangkan jika kamu kelupaan atau salah seting permission filenya ke publik bisa rewrite?
Belum lagi banyak ditemukan kasus meskipun sudah di set di robots.txt disallow tapi tetap bisa di detek orang melalui pencarian di google memakai dork seperti site:domainkamu inurl: apa gitu.
Atau link tetap tampil tapi di description pencarian (deskripsi halaman ini di block oleh robots txt) tapi tetap dindeks berarti.
Jadi bagi yang masih bingung ketika cek di Google Search Console (GSC) atau Google webmaster tools (GWT)
“kok index website saya banyak banget indexnya padahal isinya gak segitu dan sudah di disallow di robots.txt” ?
Sudah terjawab bahwa disallow di robots.txt bukan berarti serta merta tidak diindeks.
Belum lagi faktor 404 yang tidak secepat itu di deindex sama Google
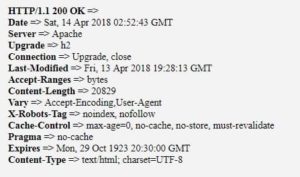
Beda jika memakai X-Robots-Tag HTTP header, orang mah nggak bisa lihat status index, noindex tidaknya, nofollow atau tidaknya karena status header tag hanya bisa dibaca robots mesin pencari.
Dan kalau kamu ingin ceki-ceki bisa memakai tool seperti http header check dari webconfs ini. Disana baru kelihatan statusnya.
Oiya untuk halaman / landing page meskipun tidak memakai x-robots-tag http header ini, kamu bisa pakai meta seperti <meta name=”Robots” content=”noindex” />
Balik lagi ke yang bilang “old school” dan sudah bukan eranya lagi tadi, btw redirect 301, 302, 307, not found 404, 500 error dan lainnya apakah old school juga ?
Seperti inilah fungsi x-robots-tag http header, benar-benar sinyal untuk mesin pencari.
Pengaruh Indexing
Semakin banyak page diindeks oleh Google memang makin bagus, tapi indeks yang seperti apa dulu (ini filternya). Jika yang diindeks halaman kurang bermutu seperti copas website lain.
Canibalism Page
Duplikat dari website sendiri (canibalism) atau file yang tidak perlu diindeks ikut keindeks sama saja seperti parasit dalam website tersebut.
Ini akan menghancurkan dari dalam meskipun sudah dipasang canonical tapi jika website besar cukup sulit mengontrolnya. Jika sudah hancur dari dalam Onsitenya, bersaing dengan kompetitor makin sulit.
Setting X-Robots-Tag Http Header
Jika memakai x-robots ini kamu juga leluasa file mana saja yang mau di set nofollow, noindex, noarchive, noodp.
Caranya hanya dengan menambahkan file .htaccess (dot htaccess) di folder yang ingin di pasang X-Robots-Tag HTTP header-nya.
Misal kamu ingin noindex dan nofollow file “khusus di wordpress, kamu cukup ke folder tersebut dan di dalam folder itu buat file dengan nama .htaccess dan isi file ini dengan kode
Header set x-robots-Tag: “noodp, noarchive, nofollow, noindex”
Terserah sih kamu pengennya apa bisa di kombinasikan dengan pilihan seperti Header set x-robots-Tag: “noindex, nofollow” atau Header set x-robots-Tag: “index” “nofollow” begitu juga dengan folder lainnya.
Saya hanya mencontohkan web yang memakai web server Apache, Untuk Nginx bisa cari banyak tutorialnya di google.
Atau jika hanya ingin noindex file .css, .js, .tf, woff2, .svg dan file non html lainnya langsung saja pasang di file htaccess utama dengan kode seperti ini:
<Files ~ “\.(css|js|[ot]tf|eot|woff2?|svg)$”>
Header set X-Robots-Tag “noindex”
</Files>
jadi jangan heran jika ketika cek robots teks website orang hanya berisi robots:
User-agent: *
Allow: /Sitemap: http://domainku/sitemap.xml
Tapi kok SEO nya maknyus, apa gak banyak duplikat nantinya ?
Padahal tanpa sepengetahuan kamu, mereka sudah pasang X-Robots-Tag HTTP header di setiap folder yang gak boleh diindex ditambah setting parameter di Google Web Console Tools.
Atau para penganut link building blog placement, yaitu pasang artikel di blogger dengan ngelink dofollow ke website merek
Tapi efeknya gak ada ?
Lalu mulailah mengambil kesimpulan kalau blog placement gak bagus atau domain authority nya jelek.
Guys domain authority itu hanya metric dari Moz, pihak google sudah klaim bahwa mereka tidak berafiliasi dengan moz.
Bagi saya sendiri arti domain authority itu bukan nilai dari yang diberikan oleh tool “MOZ” tapi authority dari Google sendiri.
Seperti apa ?
Niche atau tema website cocok dengan web kita, atau hampir seluruh isi / content dalam web kita memiliki value, mulai dari trafik hingga backlink.
Jika kamu harus memilih mana antara:
- website memiliki banyak backlink tapi yang dapat backlinks cuma homepage, atau 5 halaman lain selain homepage dari total content 100 biji atau lebih parah lagi dari total link tak berguna yang turut diindex juga (parasit page).
- Website memiliki sedikit backlink tapi backlink tersebut merata ke hampir setiap halaman website kita (landing page) dan juga website yang indexnya hanya halaman yang penting-penting saja
Inilah authority yang sebenarnya bagi saya pribadi.
Domain Authority Tinggi Tapi Kok Gak Diindex / No Backlink Value
Begitu juga jika Anda link building dengan gratisan dan gak tanggung-tanggung domainnya .gov dan .edu Coy, atau domain biasa tapi ketika DA/PA dicek 50 keatas.
Namun pas di ceki-ceki beberapa bulan kok gak diindex juga bahkan sudah ikut di backlink juga loh. Diperiksa di robots teks domain itu gak di block (disallow).
Cek page html juga gak ada <meta name=”robots” content=”nofollow, noindex” /> usut punya usut ternyata DOI memakai X-Robots-Tag HTTP header, nah loh.
Backlink-backlink jenis ini justru membuat efek buruk bagi SEO website Anda sendiri terutama offpage seo.
Bayangkan website kamu dapat backlink dari halaman yang di noindex loh, mudah banget robots detek kalau itu link spam.
Kalau cuma nofollow masih mending sih karena nofollow juga baik sebagai penetralisir link building kamu. Kembali ke pertanyaan, gimana kalau link building pakai BOT ? haah.
Yang manual aja bisa begini loh apalagi pakai bot, belum lagi apalah nikmatnya link building pakai bot.
SEO adalah seni dan link building adalah teknik seni terbesar dalam SEO, disini kamu bisa menganalisa atau memakai teknik baru dan yang pasti lebih enjoy sebagai the real SEO specialist.
Permasalahan SEO Agency
a) Permasalahan umum yang dialami oleh SEO agency dengan klien atau pelanggannya adalah pihak klien sangat mengharuskan backlinks report dan banyak lagi.
Padahal harusnya performa KPI (keywords maupun trafik) yang dijadikan faktor utama.
SEO agency team bakal pecah fokus karena backlinks report yang buanyak ini. Belum lagi harus seleksi backlink profile agar benar-benar mendapatkan hasil yang maksimal.
b) Pihak klien ogah-ogahan merevisi atau memperbaiki SEO Onsitenya, apalagi site audit yang besar-besaran.
So, sudah jelas kenapa saya pribadi lebih prefer memakai teknik X-Robots-Tag HTTP header ini dan dalam study case saya.
Cara ini lebih disukai oleh google dibandingkan robots.txt karena ini berarti “silahkan di crawl semua tapi jangan diindeks file ini”.
Robot mesin pencari tidak terhambat merayapi halaman web kamu dan kamu sudah beri warning jangan diindeks file tersebut. Ini maksudnya!!
Kesimpulan:
x-robots-tag ini bisa dipasang di setiap folder baik itu file HTML maupun file NON HTML yang tidak ingin diindeks termasuk CSS atau JS file.
Meta tag noindex dengan x-robots-tag berbeda penerapannya, meta tag hanya bisa dipasang di halaman web/ landing page atau berupa file html dari folder tersebut tapi kalau x-robots-tag menyeluruh.
Halaman Not found sebaiknya di noindex, status header not found juga 404 not found bukan 401 atau malahan 200 OK karena kedetek masih eksis dan indeks akan bertahan lama
404 not found bisa saja di redirect 301 permanent asal ke halaman yang related (folder induknya). Jika terlalu banyak 404 not found (biasanya ecommerce) redirect yang seperlunya saja.
Biarkan saja tetap 404 toh status headernya sudah 404 not found, tapi agar visitor tidak kecewa tambahkan saja related content / produk di halaman tersebut.
Pada dasarnya file not found 404 tidak terlalu membahayakan SEO website Anda, 404 akan membahayakan SEO manakala link file 404 tersebut banyak terdapat di internal linking.
Memilih Blog untu placement
Jika ingin link building memakai blog placement, sebaiknya pilih blogger yang agak gaptek masalah teknik seo (hmmm)
Cek juga http header folder link profil kamu, misalnya kamu punya backlinks di .gov dan .edu (biasanya permalinknya domain.edu/profile/bla-bla),
kalau jelas-jelas di meta nya ada noindex jangan dipakai, kalau tidak ada cek lagi x-robots-tag header nya.
Jangan mudah tergoda dengan backlink profile kompetitor mu atau karena high domain authority dan look like dofollow pula.
Private Blog Network sebagai alternatif lain, tapi yang benar-benar PBN Management terencana dengan baik yah atau yang kamu develop sendiri, bukan jasa PBN yang SALOME (Satu Lobang Rame-rame)
Dikembalikan ke pilihan masing-masing